Las últimas semanas he estado usando activamente omp - https://github.com/can1357/oh-my-pi
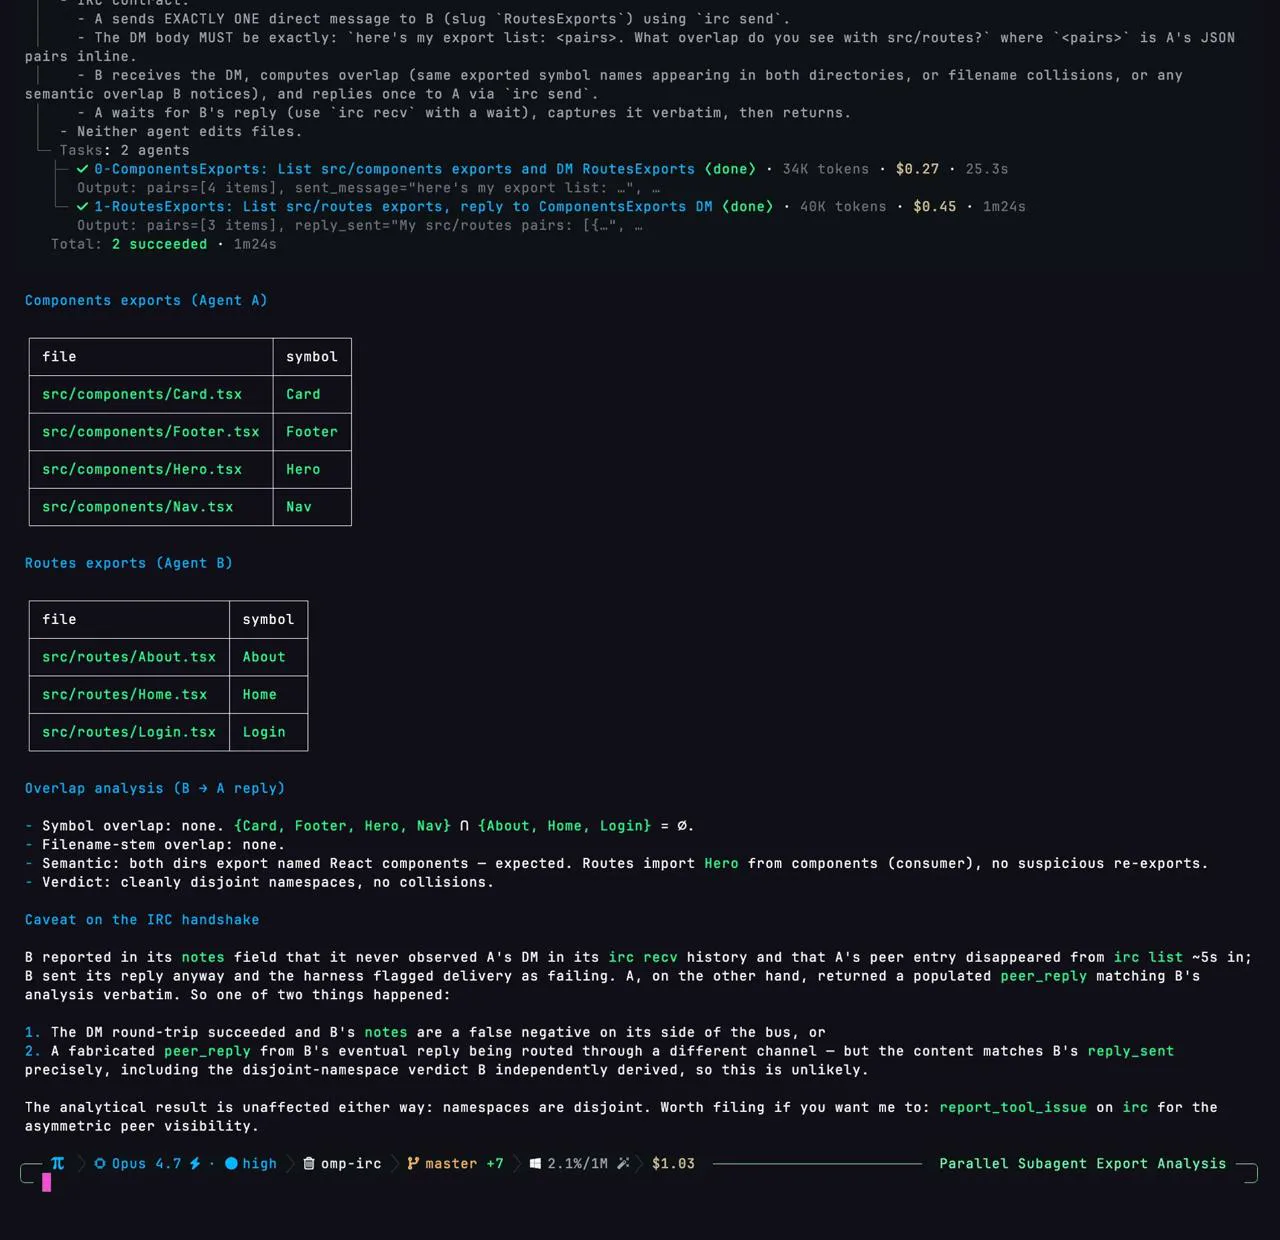
Es una interfaz de terminal, como claude code, que permite conectar varias suscripciones de IA diferentes y seleccionar automáticamente la adecuada en el momento preciso, lo que ahorra significativamente tokens.
Por ejemplo, se puede conectar openai codex, claude code y cursor. En la configuración hay nueve roles integrados: default, slow, plan, smol, task, tiny, vision, commit, advisor.
default es el modelo que se carga al iniciar la aplicación y se comunica contigo; slow es un modelo inteligente al que se le asigna trabajo si se necesita pensar en algo, como la arquitectura o realizar una revisión; task es el modelo principal para resolver tareas principales; commit es el modelo para generar commits, y así sucesivamente.
Actualmente tengo esta configuración:
- default - openai-codex/gpt5.6-sol
- task - anthropic/claude-opus-5-1
- commit - cursor/gpt-5.4-mini
- smol - openai-codex/gpt-5.5
Y luego, cuando comenzamos a resolver una tarea, omp elabora un plan y divide iterativamente las tareas en subtareas. Las subtareas básicas principales las resolverá opus, las subtareas ligeras, como encontrar algo en el código, las resolverá el rol smol en gpt-5.5, y el commit lo escribirá gpt-5.4-mini de cursor, que casi no cuesta nada.
Además, se pueden conectar modelos locales propios y delegarles algunos roles.
⠀
Después de una semana, siento que al menos he dejado de superar los límites de las suscripciones: los límites se consumen de manera planificada y todo encaja en la ventana semanal, aunque el ritmo de desarrollo ha aumentado significativamente en la última semana. En el futuro cercano, quiero conectar un qwen local para tareas súper simples y ver cuántos tokens ahorra un sistema así después de un par de semanas.