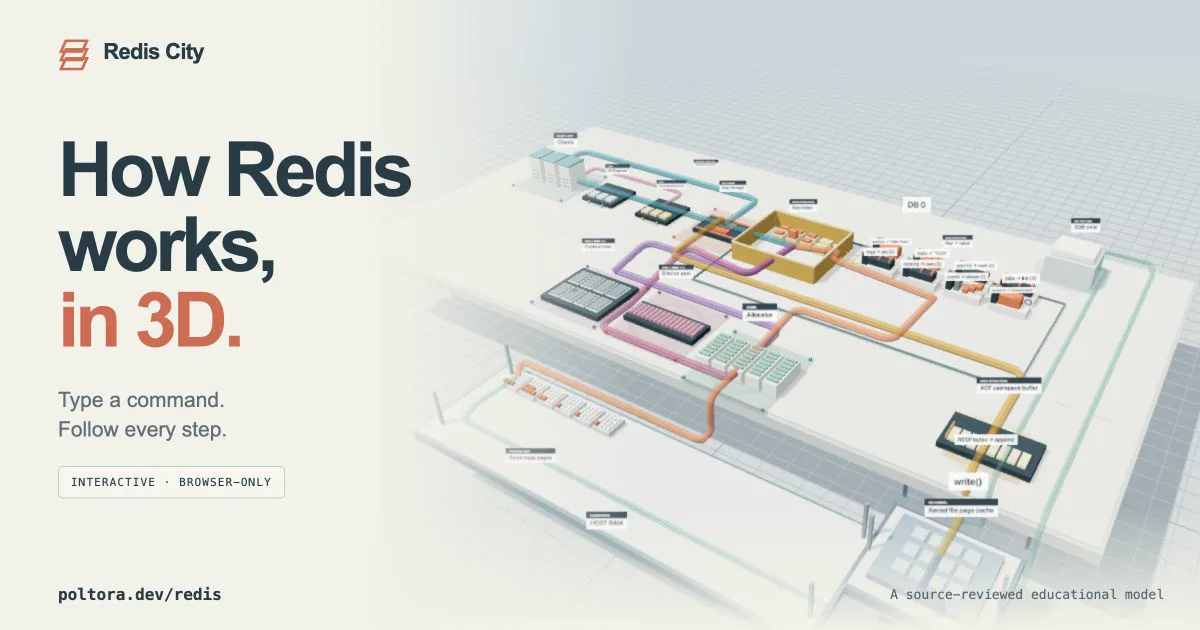
Inspirado por um projeto que criou um mapa interativo do funcionamento interno do Postgres (falei sobre ele aqui), decidi montar um mapa parecido para o Redis: poltora.dev/redis.
Não é apenas um diagrama estático. Dá para navegar pelo mapa, abrir o console integrado, executar comandos e acompanhar a execução passo a passo: desde o socket e o parser RESP até a busca pela chave, a alocação de memória, a geração da resposta e a gravação em AOF ou RDB.
O que exatamente o mapa mostra
No centro está o modelo de uma única instância do Redis. O comando parte do cliente, chega ao buffer da conexão, é processado pelo parser RESP, passa pela validação e é executado na thread principal. Depois disso, o mapa mostra separadamente o trabalho com o keyspace, o objeto e sua representação na memória, a fila de resposta ao cliente e, para comandos que alteram dados, o caminho dos dados até o AOF.
Atualmente, o modelo entende as principais operações com strings, hashes, listas, conjuntos, sorted sets e streams. Por exemplo, é possível executar SET, GET, DEL, HSET, HGETALL, LPUSH, LRANGE, SADD, ZRANGE, XADD, EXPIRE, TTL, MEMORY USAGE e BGSAVE. A lista completa está disponível pelo comando HELP no console integrado.
Alguns cenários contam com experimentos prontos. Eles permitem comparar uma string curta com uma longa, observar a mudança do encoding interno de uma estrutura, acompanhar a expiração do TTL, criar pressão sobre maxmemory, iniciar um BGSAVE e observar o copy-on-write quando o processo pai altera dados durante a criação do snapshot.
De onde veio o modelo
O mapa foi baseado na análise do código-fonte do Redis 8.10.1. O fluxo de um comando comum foi reconstruído a partir de networking.c, server.c, db.c, kvstore.c, dict.c e das implementações dos tipos de dados específicos. Para o AOF, acompanhei separadamente o caminho desde o buffer server.aof_buf, passando pelo write() do sistema até o page cache do kernel e, depois, até o armazenamento persistente. Para o RDB, o mapa mostra um processo BGSAVE separado, que inicialmente compartilha páginas físicas de memória com o processo pai e depois recebe suas próprias páginas quando ocorre uma escrita, graças ao copy-on-write.
Por isso, o mapa não inclui uma “fila geral de comandos” inventada nem um serviço separado para cada etapa. Cada cliente tem seu próprio buffer de entrada e sua lista de comandos preparados, mas a execução dos comandos converge para a thread principal. Um GET comum lê o objeto da memória e não acessa o AOF, o RDB nem o disco.
Memória não é apenas o tamanho do valor
Um dos objetivos do projeto é mostrar por que o tamanho do payload e o consumo de memória do processo do Redis não são a mesma coisa. O modelo separa os dados úteis, a solicitação ao alocador, a size class, as páginas do alocador, a memória residente do processo e o page cache de arquivos do kernel.
Excluir uma chave libera o slot, mas não necessariamente devolve a página física ao sistema operacional de imediato. Vários objetos podem compartilhar uma mesma página do alocador, e ela continua residente enquanto houver regiões ocupadas. Por isso, depois de um DEL, o volume lógico dos dados diminui imediatamente, mas o RSS pode permanecer igual. Isso aparece claramente no experimento de liberação de memória.
O que foi simplificado
Redis City é um modelo educacional, não um binário do Redis em execução, um emulador de jemalloc ou um profiler. Os comprimentos das strings UTF-8 são calculados, mas os overheads dos objetos, as size classes, a distribuição entre páginas e a duração das operações são aproximações. O RSS básico é definido como uma premissa e não mede a memória do computador do visitante.
A disposição visual dos blocos também não representa um mapa físico de endereços. Ela mostra as relações entre os subsistemas. Por exemplo, a camada superior com os objetos é uma representação semântica do keyspace, a camada inferior é um modelo das páginas residentes, e o page cache do AOF e do RDB pertence ao kernel do sistema operacional, não ao heap do processo do Redis.
Cluster, replicação, Sentinel, Lua/functions, Pub/Sub, transações e módulos ainda não fazem parte do modelo. Essa é uma limitação intencional: se todos os subsistemas fossem exibidos ao mesmo tempo, o fluxo normal de um SET ou GET deixaria de ser legível.
Como tudo é executado
O simulador roda inteiramente no navegador. Ele não se conecta a uma instância real do Redis, não solicita senha e não altera nada no servidor. O modelo de comandos foi escrito em TypeScript, a cena foi montada proceduralmente com Three.js e o build é publicado como HTML, CSS e JavaScript estáticos. Em produção, o mapa não precisa de um processo Node.js separado, Redis ou banco de dados.
O comando é processado uma única vez e, em seguida, a interface mostra o resultado por meio de uma sequência de checkpoints: DB, allocation, TTL, journal e durability. Ao reproduzir novamente a animação, o estado anterior ao comando é restaurado, sem executá-lo uma segunda vez.
Como experimentar
Abra o Redis City, expanda o Console e comece com um cenário simples:
SET city "Hello Redis"
GET city
DEL city
Depois, experimente SET temporary hello EX 6, acompanhe o TTL e execute GET temporary após o tempo simulado expirar. Para um cenário mais complexo, inicie um BGSAVE e altere uma chave existente durante a criação do snapshot — o mapa mostrará qual página foi separada por copy-on-write.
O projeto continua sendo um modelo, então seu principal objetivo não é fornecer métricas exatas de desempenho, mas tornar observáveis as transições invisíveis do Redis e separar o comportamento real das simplificações mais comuns.