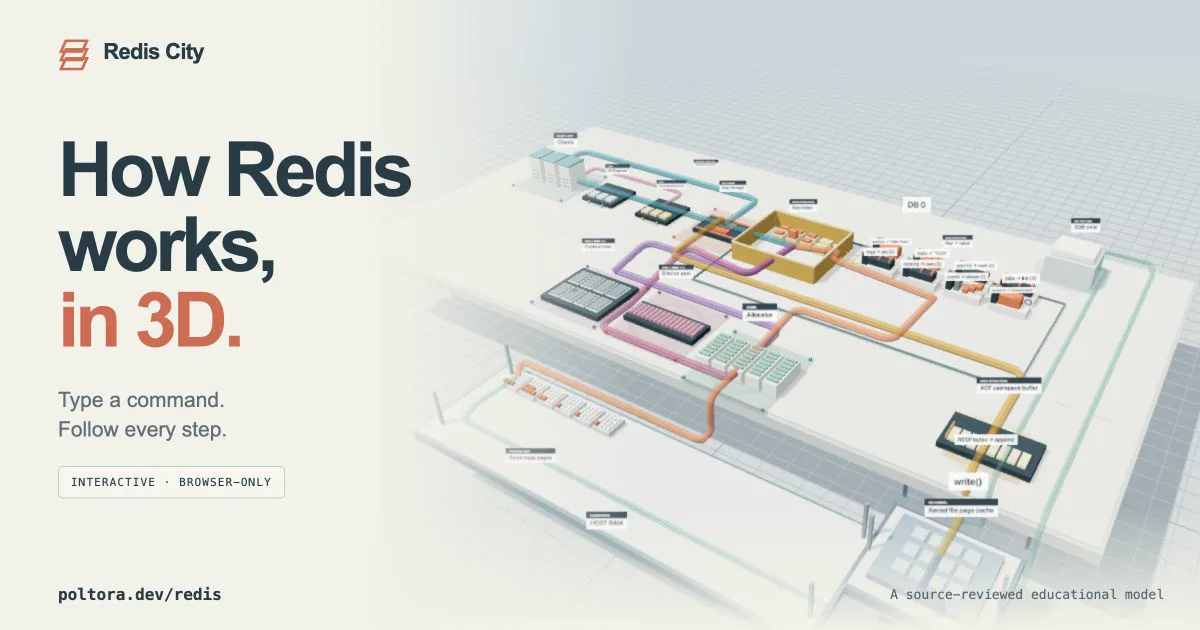
Inspirado por un proyecto que creó un mapa interactivo del funcionamiento interno de Postgres (escribí sobre él aquí), decidí hacer un mapa parecido para Redis: poltora.dev/redis.
No es un simple diagrama estático. Puedes desplazarte por el mapa, abrir la consola integrada, ejecutar comandos y ver su ejecución paso a paso: desde el socket y el parser RESP hasta la búsqueda de la clave, la asignación de memoria, la generación de la respuesta y la escritura en AOF o RDB.
Qué muestra exactamente el mapa
En el centro hay un modelo de una única instancia de Redis. El comando parte del cliente, llega al búfer de la conexión, el parser RESP lo analiza, pasa por la validación y se ejecuta en el hilo principal. Después, el mapa muestra por separado el trabajo con el keyspace, el objeto y su representación en memoria, la cola de respuesta al cliente y, en el caso de los comandos que modifican datos, el recorrido de esos datos hasta AOF.
Actualmente, el modelo entiende las principales operaciones con strings, hashes, listas, conjuntos, sorted sets y streams. Por ejemplo, puedes ejecutar SET, GET, DEL, HSET, HGETALL, LPUSH, LRANGE, SADD, ZRANGE, XADD, EXPIRE, TTL, MEMORY USAGE y BGSAVE. La lista completa está disponible mediante el comando HELP en la consola integrada.
También hay experimentos preparados para varios escenarios. Permiten comparar un string corto con uno largo, observar cómo cambia el encoding interno de una estructura, seguir la expiración del TTL, generar presión sobre maxmemory, iniciar BGSAVE y ver el copy-on-write cuando el proceso padre modifica los datos mientras se crea el snapshot.
De dónde sale el modelo
El mapa se basa en el análisis del código fuente de Redis 8.10.1. El recorrido de un comando normal se reconstruyó a partir de networking.c, server.c, db.c, kvstore.c, dict.c y las implementaciones de cada tipo de datos. Para AOF, seguí por separado el recorrido desde el búfer server.aof_buf, pasando por la llamada de sistema write() hasta la page cache del kernel y, finalmente, el almacenamiento persistente. Para RDB, se muestra un proceso BGSAVE independiente que al principio comparte las páginas físicas de memoria con el proceso padre y después obtiene sus propias páginas al escribir gracias al copy-on-write.
Por eso, el mapa no incluye una «cola global de comandos» inventada ni un servicio separado para cada paso. Cada cliente tiene su propio búfer de entrada y una lista de comandos preparados, pero la ejecución de todos los comandos converge en el hilo principal. Un GET normal lee el objeto de la memoria y no accede a AOF, RDB ni al disco.
La memoria no es solo el tamaño del valor
Uno de los objetivos del proyecto es mostrar por qué el tamaño del payload no coincide con el consumo de memoria del proceso de Redis. El modelo separa los datos útiles, la solicitud al allocator, la size class, las páginas del allocator, la memoria residente del proceso y la page cache de archivos del kernel.
Eliminar una clave libera su espacio, pero no necesariamente devuelve de inmediato la página física al sistema operativo. Varios objetos pueden compartir una misma página del allocator, que permanece residente mientras contenga regiones ocupadas. Por eso, después de DEL, el volumen lógico de los datos disminuye inmediatamente, pero el RSS puede mantenerse igual. Esto se muestra por separado en el experimento de liberación de memoria.
Qué aspectos están simplificados
Redis City es un modelo educativo, no un binario de Redis en ejecución, un emulador de jemalloc ni un profiler. Se calculan las longitudes de los strings UTF-8, pero el overhead de los objetos, las size classes, la distribución en páginas y la duración de las operaciones son aproximaciones. El RSS base se establece como una suposición y no mide la memoria del equipo del visitante.
La disposición visual de los bloques tampoco representa un mapa físico de direcciones. Muestra las relaciones entre los subsistemas. Por ejemplo, la capa superior con los objetos es una representación semántica del keyspace, la capa inferior es un modelo de las páginas residentes, y la page cache de AOF y RDB pertenece al kernel del sistema operativo, no al heap del proceso de Redis.
El clúster, la replicación, Sentinel, Lua/functions, Pub/Sub, las transacciones y los módulos todavía no forman parte del modelo. Es una limitación deliberada: si mostrara todos los subsistemas al mismo tiempo, el recorrido habitual de SET o GET dejaría de ser legible.
Cómo funciona todo
El simulador se ejecuta por completo en el navegador. No se conecta a una instancia real de Redis, no solicita ninguna contraseña ni modifica nada en el servidor. El modelo de comandos está escrito en TypeScript, la escena se genera de forma procedural con Three.js y el build se publica como archivos estáticos HTML, CSS y JavaScript. En producción, el propio mapa no necesita un proceso Node.js independiente, Redis ni una base de datos.
El comando se calcula una sola vez y, después, la interfaz muestra el resultado mediante una secuencia de puntos de control: DB, allocation, TTL, journal y durability. Al volver a reproducir la animación, se restaura el estado anterior al comando sin ejecutarlo por segunda vez.
Cómo probarlo
Abre Redis City, despliega Console y empieza con un escenario sencillo:
SET city "Hello Redis"
GET city
DEL city
Después, prueba SET temporary hello EX 6, sigue el TTL y ejecuta GET temporary cuando haya transcurrido el tiempo simulado. Para un escenario más complejo, inicia BGSAVE y modifica una clave existente mientras se crea el snapshot: el mapa mostrará qué página se separó mediante copy-on-write.
El proyecto sigue siendo un modelo, así que su objetivo principal no es ofrecer métricas de rendimiento exactas, sino hacer observables las transiciones invisibles de Redis y distinguir el comportamiento real de las simplificaciones más habituales.